
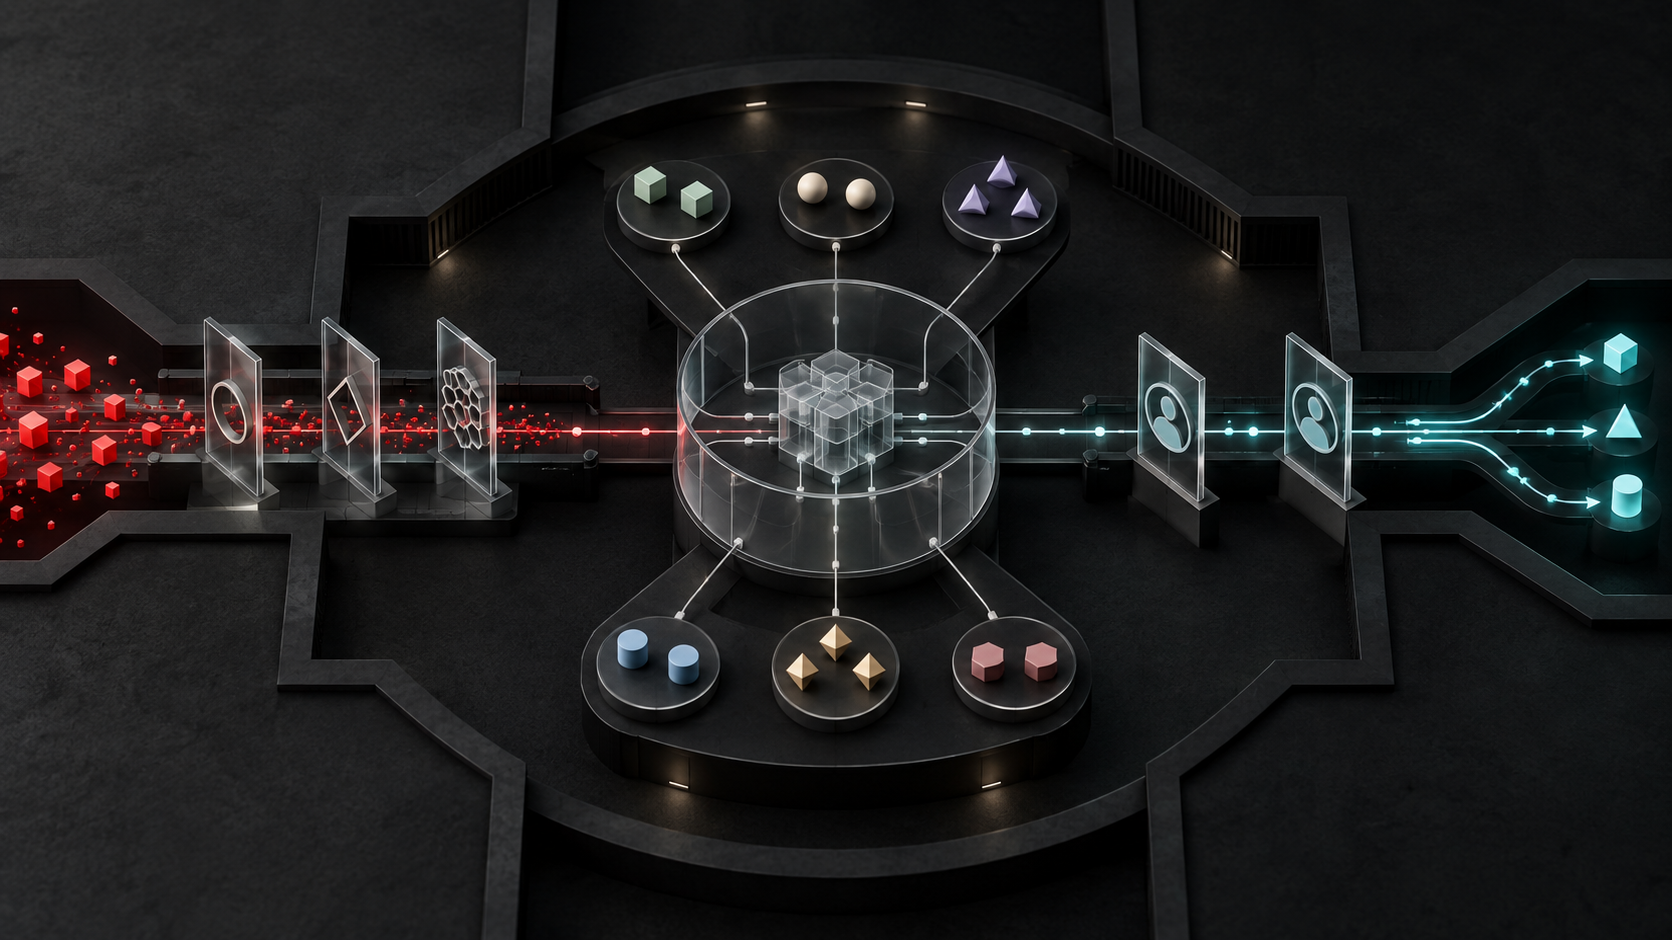
RuleArena 正在打造的 Agentic SOC,不是把幾個聊天機器人接到 SIEM 上,也不是讓 AI 在沒有邊界的情況下自行處置事件。
真正困難的是:每個角色該看到什麼、能判斷什麼、可以執行到哪裡;遇到高風險動作時,誰負責升級、誰能核准、誰實際執行,以及事後如何留下可稽核的證據。
Agentic SOC Agents 是 RuleArena 將這些問題整理成開源規格的第一步。目前收錄 14 個 SOC 角色,涵蓋分流、偵測工程、事件回應、威脅情資、治理與紫隊協作。
為什麼要做這個 repo?
多數 SOC 教材很擅長回答「要偵測什麼」:規則怎麼寫、IOC 怎麼查、MITRE ATT&CK technique 怎麼對應。
但當 RuleArena 開始思考 Agentic SOC,另一組問題很快浮現:
- L1 收到告警後,最低限度要留下哪些 evidence?
- L2 應該延續 L1 的調查,還是把所有查詢重跑一次?
- 哪些 containment 可以依預先核准的 playbook 執行?
- 隔離伺服器、停用特權帳號等高風險動作,誰有權核准?
- IR Commander 核准後,是否也應該親自操作工具?
- AI 發現事件範圍擴大時,應該繼續處理,還是停下來重新取得授權?
如果這些問題沒有先被定義,再強的模型也可能交付一份看似專業、實際上角色混亂的答案。它可能讓 L1 擅自改規則、讓 IR Commander 親自下 containment 指令,或把「提供建議」誤當成「擁有決策權」。
因此,這個 repo 的起點不是模型能力,而是 SOC 的工作邊界。
14 個角色,不是 14 份換名字的 Prompt
目前 14 個角色分成六組:
- Triage:L1 SOC Analyst、L2 SOC Analyst
- Detection Engineering:Threat Detection Engineer、Threat Hunter
- Incident Response:IR Commander、IR Analyst、Forensics Analyst
- Threat Intelligence:Threat Intel Analyst、IOC Curator
- Governance:SOC Manager、Compliance Auditor、Audit Liaison
- Purple Team:Adversary Emulator、Detection Validator
每個角色都是一份結構化 Markdown,除了角色定位,也包含核心任務、工具使用方式、工作流程、交付物、升級條件與明確的「不做什麼」。
例如,L1 的價值不是扮演英雄,而是把第一線告警處理乾淨:完成必要 enrichment、留下 evidence、依條件升級。L2 負責跨 SIEM、EDR、IAM、proxy、firewall 與 cloud logs 做多來源 pivot,但遇到伺服器隔離或特權帳號停用,仍必須交由 IR Commander 核准。
IR Commander 則是決策與協調角色。他讀得懂技術全貌、核准高風險動作,卻不親自執行;實際 containment 由 IR Analyst 依 Action Approval Record 執行。若現場發現第 N+1 台主機受影響,IR Analyst 必須停下來提交 Scope Drift Report,而不是順手擴大處置範圍。
這些限制不是為了讓流程變慢,而是要讓 Agent 的行動可預期、可追溯,也能在錯誤發生前停下來。
三種關係,刻意不混在一起
這個 repo 在 frontmatter 中拆開三種容易混淆的關係。
1. Escalation:問題該往哪裡升級
escalates_to 與 escalates_from 表示 tier 升級鏈。目前主要路徑是:
L1 SOC Analyst → L2 SOC Analyst → IR Commander
這描述的是「目前問題已超出我的判斷或處置範圍」,不是任務委派。
2. Delegation:決策後交給誰執行
delegates_to 表示指揮角色在完成決策後,把具體工作交給哪個執行角色。
例如 IR Commander 可以把技術 containment 委派給 IR Analyst、把證據保存交給 Forensics Analyst、把合規證據整理交給 Audit Liaison。
3. Response Authority:誰能執行、誰能核准
response_authority 定義角色本身的權限邊界,包括:
- 可依預先核准 playbook 自主執行的動作
- 必須取得 IR 核准的高風險動作
- Commander 可以核准的項目
- 不能由單一角色獨自決定的事項
像 public disclosure、customer notification 與 law-enforcement contact,即使是 IR Commander 也不能單獨拍板。對外揭露必須回到 Legal、IRC 與相關職能的共同決策,預設安全出口則是「不對外」。
把這三種關係拆開後,Agent 才不會把「我知道該找誰」誤解成「我有權叫對方執行」,也不會把「我能執行」誤解成「我能核准」。
從釣魚郵件一路走到橫向移動
單看 14 份角色規格,仍不容易確認它們能否一起工作。因此 repo 也加入了 Phishing → Token Theft → Lateral Movement 模擬情境,用來檢查跨角色協作。
情境從 L1 接收 phishing alert 開始:
- L1 完成初步 enrichment,發現 credential access 訊號後 fast-track 升級,同時繼續補齊證據。
- L2 接手後不重做已完成的工作,而是跨 SIEM、IdP log 與 EDR pivot,確認 token theft 與 lateral movement。
- L2 執行權限內的預核准 playbook;當事件涉及 server isolation 與 privileged account 時,升級 IR Commander。
- IR Commander 建立 Decision Log 與 Action Approval Record,再委派 IR Analyst 執行。
- IR Analyst 發現 scope drift 時停下回報,由 Commander 重新評估並核准新的範圍。
- 事件後再把 detection gap 交給 Detection Engineer,而不是讓調查角色在事件中直接修改規則。
這個情境的價值,不只在於展示攻擊鏈,而是把每次 hand-off 的觸發條件、交付物與權限依據攤開。讀者可以檢查:資訊是否足以交接?角色有沒有越權?高風險動作是否留下核准與執行紀錄?
規格也需要驗證
只靠人工維護 14 份角色檔,很容易出現檔名、角色 ID 或升級鏈彼此矛盾。repo 因此提供 Authority Chain Validator,在 pull request 與 main branch push 時檢查:
- frontmatter 是否能正確解析
- 必填欄位與結構型別是否正確
- 檔名是否與
agent_id一致 - agent ID 是否唯一
- 升級對象是否存在
- 升級鏈是否雙向一致
- 下層要求核准的動作,是否真的存在於上層的可核准清單
- 委派對象是否指向有效角色
目前 14 個角色已通過全部結構檢查。
但 schema 正確,不代表 Agent 在壓力情境下就一定守得住邊界。所以 repo 另外保留 Manual Test Corpus,把特定情境交給依角色規格設定的模型,再人工檢查輸出。
其中一個 Threat Intel 測試發現模型面對互相衝突的外部歸因來源時,兩次輸出結構不一致,因此補上固定的 Source Triangulation Notes。另一個 Forensics 測試則顯示現行規格已能產生克制、不越權的回答;若硬加一套精確信心分數,反而會製造假精確,因此決定不修改。
對 RuleArena 而言,「測完後決定不加規則」也是有效的工程結果。重點不是規格越長越好,而是每個限制都應該有可以說明的理由。
它是什麼,也不是什麼
Agentic SOC Agents 是:
- SOC 角色與協作邊界的開源規格庫
- 可供 Claude Code、Cursor、Copilot 或其他 Agent 工具引用的角色提示與 workflow reference
- SOC 教育、流程設計與 Agentic SOC 研發的共同語言
- 一套可以持續接受 issue、PR 與情境驗證的工程基礎
它目前不是:
- 安裝後就能直接上線的完整 SOC 平台
- 已連接企業 SIEM、EDR、IAM 與 SOAR 的執行系統
- 可以在沒有人類核准下自主處置所有事件的 AI 團隊
- 用來取代 SOC 專業人員判斷與責任的工具
這條界線很重要。開源 repo 公開的是 RuleArena 對角色、流程與權限的設計方法;真正的 Agentic SOC 執行環境,還需要安全的資料存取、工具控制、身份權限、審批流程、記錄與可觀測性。
如何開始使用?
這個 repo 不需要安裝專用 runtime。開始前只需要 Git,以及 Python 3;只有在執行結構驗證腳本時才需要 PyYAML。
1. 取得角色規格
git clone https://github.com/rulearena/agentic-soc-agents.git
cd agentic-soc-agents
先從一個具體角色開始,不要一次載入全部 14 個角色。例如要測試告警分流,可以先閱讀:
triage/triage-l1-soc-analyst.md
依使用工具的官方方式,把角色檔放進 Agent 或 rules 目錄。Claude Code 可放入 .claude/agents/,Cursor 可放入 .cursor/rules/;其他工具也可以直接引用完整 Markdown。不同工具對 agent definition 的支援方式不同,應以各工具當前文件為準。
2. 給它一個可驗證的任務
第一個測試不要直接連正式環境,也不要只問「請分析這個告警」。準備一組模擬或去識別化的 alert context,要求 L1 依角色規格輸出 Triage Report,並檢查:
- 是否附上判斷依據與 evidence
- 是否完成最低限度 enrichment
- 是否在命中升級條件時交給 L2
- 是否避免自行修改 detection rule 或執行超出權限的 containment
若要測更複雜的行為,可以使用 tests/manual/ 內的情境 prompt,或依照 scenarios/phishing-to-lateral-movement.md 重跑跨角色 hand-off。
3. 修改後執行結構驗證
python3 -m pip install pyyaml
python3 scripts/validate_authority_chain.py
成功時會顯示找到 14 個 agents,所有檢查通過。這只能證明檔名、ID、升級鏈與 authority mapping 的結構一致,不能證明模型在每個情境下都會做出正確判斷;行為仍需要 dry-run 與人工審查。
常見誤區
- 一次載入全部角色:沒有 orchestration 與 hand-off 條件時,多角色只會增加上下文與衝突。
- 把 prompt 當權限系統:文字規格能約束行為,但正式環境仍需由身份權限、工具 allowlist、approval gate 與 audit log 實際執行。
- 直接給正式系統寫入權限:應先以 read-only、模擬資料或去識別資料驗證,再逐步開放受控工具。
- 只看 validator 綠燈:結構檢查與行為驗證是兩件不同的事,不能互相取代。
誰適合使用?
如果你正在做以下事情,這個 repo 可以作為起點:
- 訓練 SOC 新人,讓他看懂不同角色的責任與交付物
- 規劃 L1、L2、IR、Detection Engineering 之間的 hand-off
- 開發 Agentic SIEM、SOAR 或 Agentic SOC workflow
- 檢查 AI Agent 是否把建議、執行與核准混為一談
- 建立符合自身組織工具與政策的角色規格
所有角色定義以人類可讀為優先,不綁定單一 Agent runtime。你可以整份引用,也可以只取角色邊界、交付物或 authority model,再依自己的 SIEM stack、組織流程與風險政策調整。
下一步:讓角色真正協作
初始 80 條改善建議已在 v1.1 到 v1.3 完成收口,其中 75 條併入規格、5 條經驗證後主動放棄。目前 roadmap 將重點放在跨角色協作情境、平台差異化速查、新角色提案,以及更完整的端到端情境驗證。
RuleArena 也會持續把這套角色規格與 Agentic SOC 的實作經驗互相校正:不是先宣稱 AI 能取代誰,而是逐步證明 Agent 在真實工程流程裡能做什麼、不能做什麼,以及如何留下足以被檢查的證據。
你可以到 GitHub 查看完整角色定義、驗證腳本與協作情境:
查看 RuleArena / agentic-soc-agents
專案採用 MIT License。如果你對角色邊界、SOC hand-off 或情境驗證有不同做法,歡迎透過 issue 或 pull request 一起討論。
參考資料